
Tensorflow capture 下面的数字是什么
创作声明:本文部分内容由AI辅助生成(AIGC),仅供参考
Python内容推荐

基于Python的单目3D人体姿态检测技术研究
资源下载链接为: https://pan.quark.cn/s/1bfadf00ae14 《Python-单目3D人体姿态检测》是基于CVPR2019年论文“Monocular Total Capture: Posing Face, Body and Hands in the Wild”开发的代码库。该研究专注于利用单个摄像头在复杂自然环境中精确检测和重建三维人体姿态,广泛应用于虚拟现实、人机交互、安防监控等领域。在计算机视觉中,“单目”指仅用一个摄像头获取信息,“Total Capture”则表示捕捉完整的人体姿态,包括脸部、身体和手部。与传统2D姿态检测相比,3D姿态检测提供更丰富的空间信息,对理解人的动作和行为至关重要。Python因其丰富的机器学习和计算机视觉库(如OpenCV、NumPy、TensorFlow和PyTorch)被选为开发语言,便于系统研发。项目实现可能包括以下关键步骤: 预处理:对输入图像进行灰度化、归一化、尺度变换等操作,为后续处理做准备。 关键点检测:利用深度学习模型(如Mask R-CNN或HRNet)定位面部、身体和手的关键点。这些模型基于大规模标注数据集训练,可精准识别关键部位。 三维重建:通过单目立体几何方法,结合关键点信息推断三维姿态,可能涉及单应性矩阵、结构光投影或深度估计技术。 数据集与标注:项目包含用于训练和验证的数据集,这些数据集需大量三维人体姿态标注,如3DPW、SURREAL或MPII等。 模型训练:使用深度学习框架(如TensorFlow或PyTorch)训练网络模型,优化损失函数以提升姿态估计精度。 后处理:对预测结果进行平滑和修正,去除噪声,增强姿态估计的稳定性和连续性。 实时应用:模型训练和优化完成后,可部署到实时系统中,实现视频流中的人体姿态实时检测和跟踪。 “MonocularTotalCapture-mast

Python-单目3D人体姿态检测
Code for CVPR19 paper "Monocular Total Capture: Posing Face, Body and Hands in the Wild"

python开启摄像头以及深度学习实现目标检测方法
今天小编就为大家分享一篇python开启摄像头以及深度学习实现目标检测方法,具有很好的参考价值,希望对大家有所帮助。一起跟随小编过来看看吧
10分钟用python实现手势识别
python实现手势识别环境准备①百度获取SDK②所需的库流程步骤①开启摄像头功能②手势识别③语音播报成果展示源码效果视频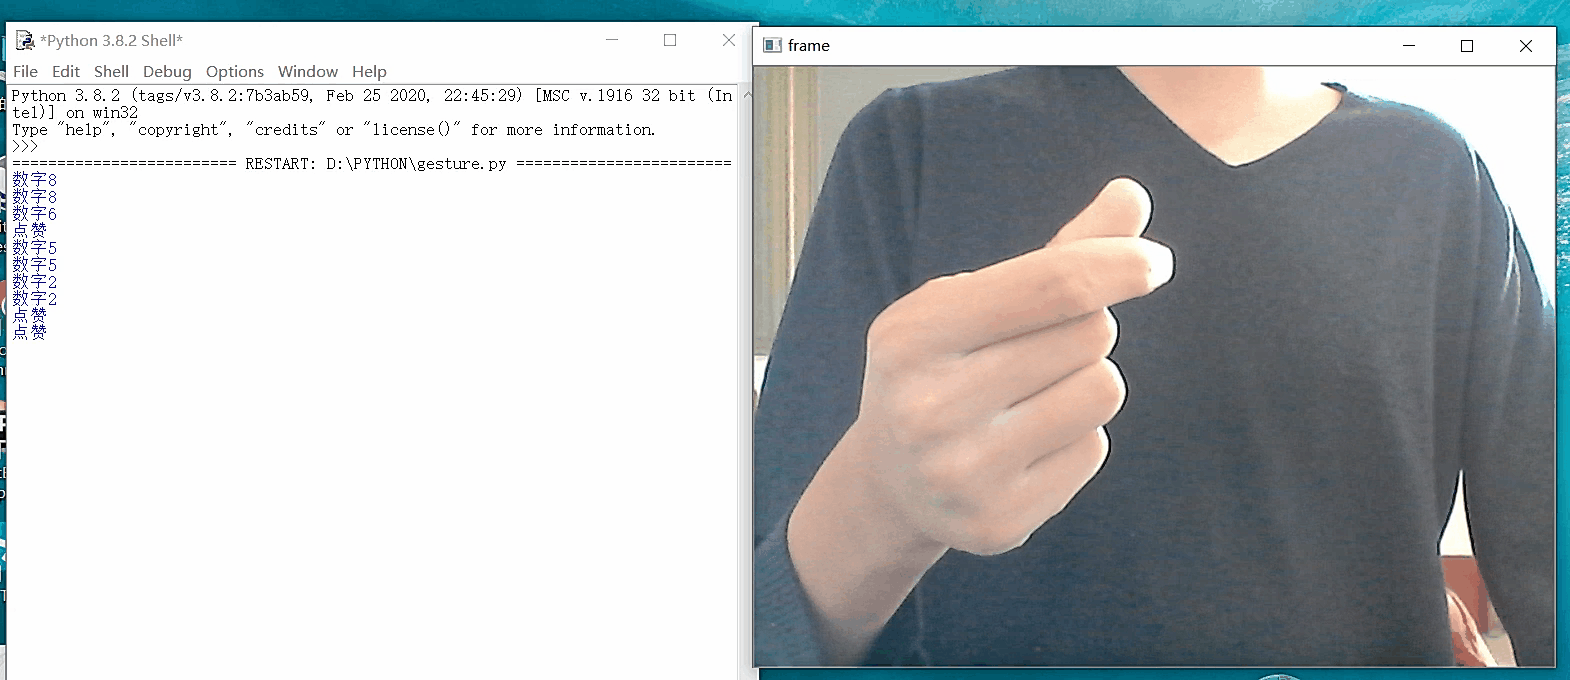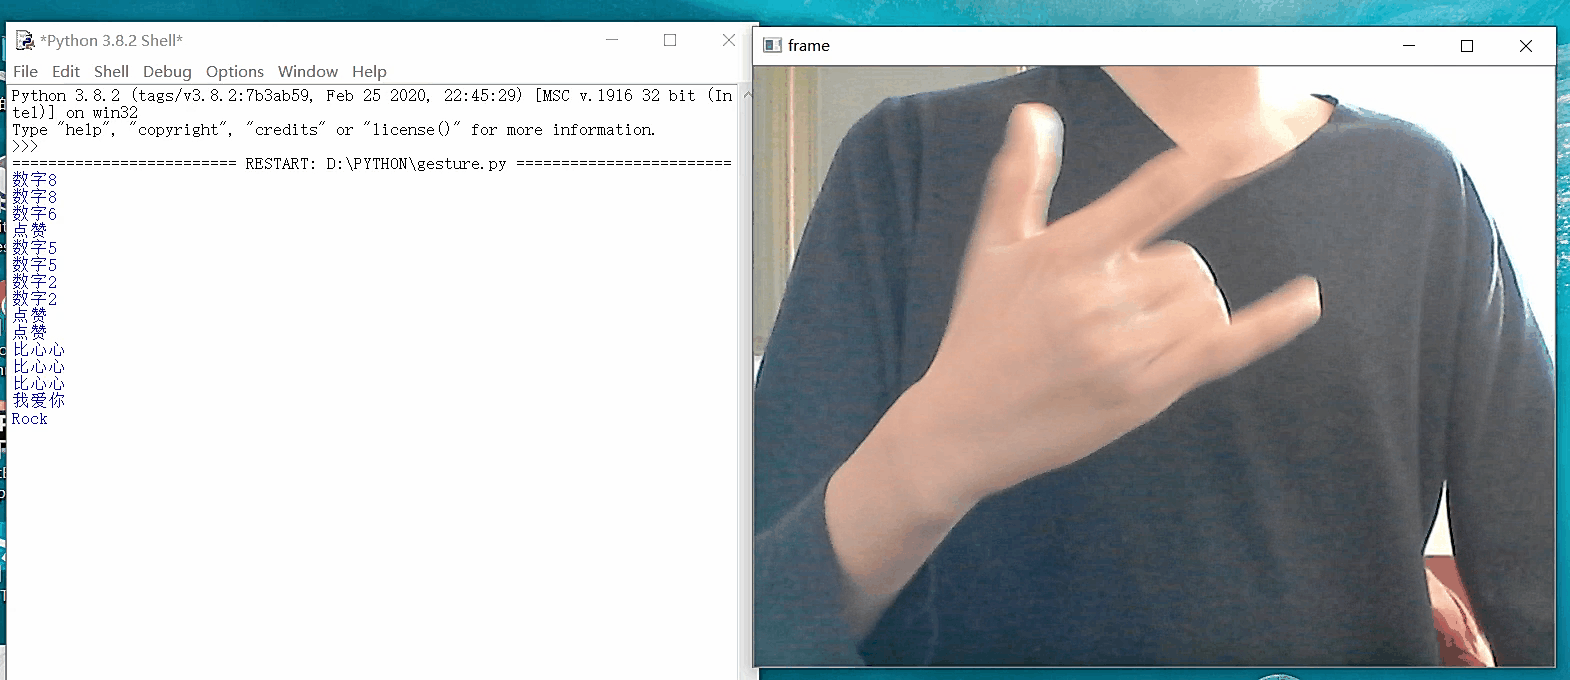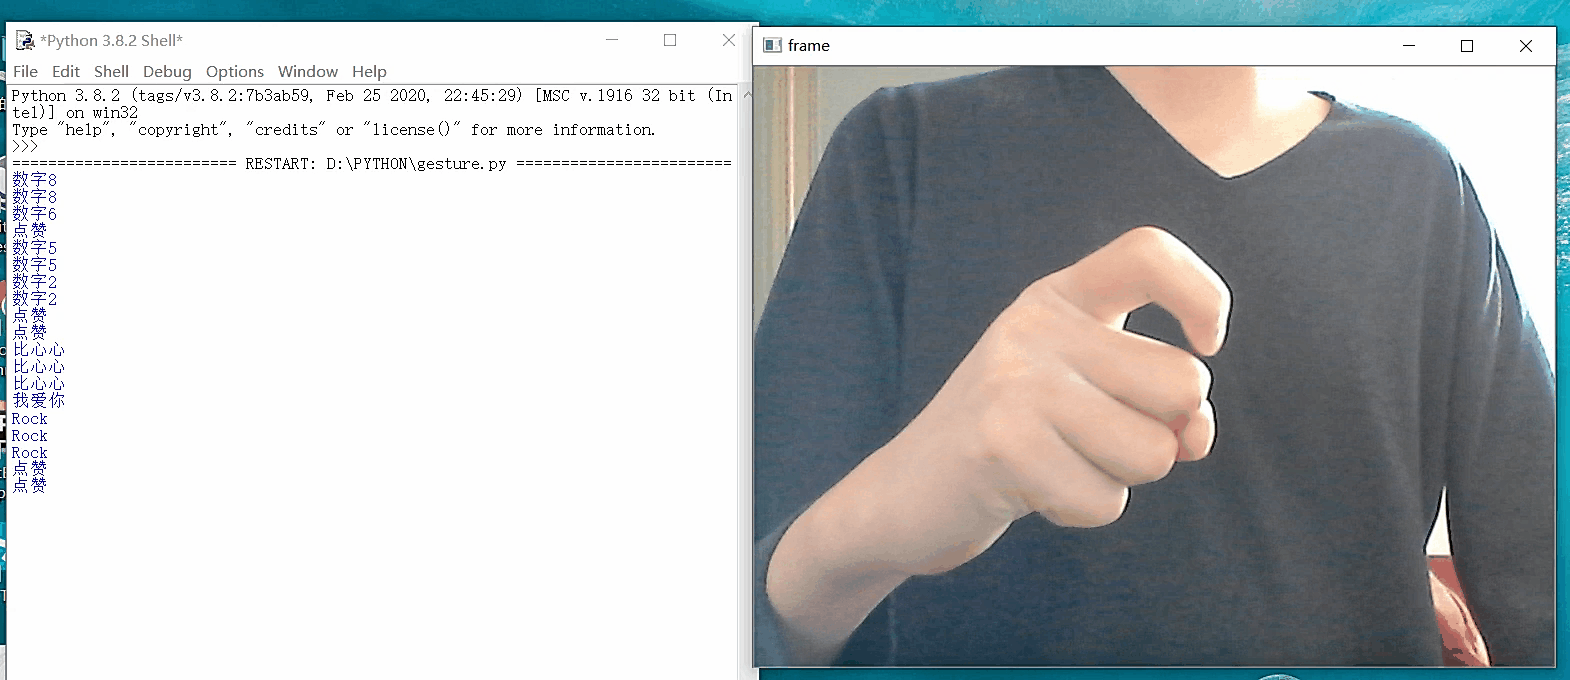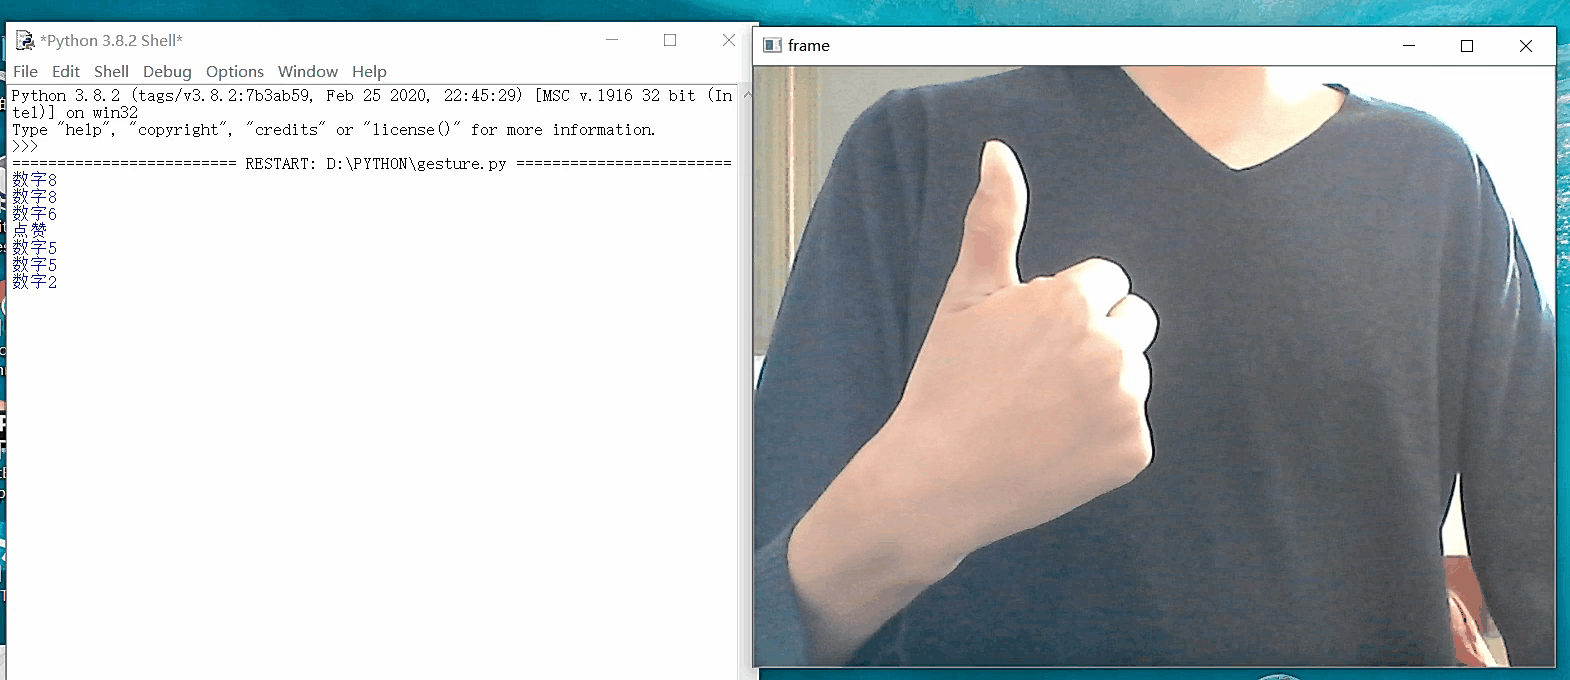 环境准备 ①百度获取SDK 浏览器搜索百度云,如未注册请先注册,然后登录点击管理控制台。点击左侧产品服务→人工智能→人体分析。点击创建应用,输入应用名称如“Baidu_OCR”,选择用途如“学习办公”,最后进行简单应用描述,即可点击“立即创建”。会出现应用列表,包括AppID、API Key、Secret Key等信息,这些稍后会用到。 点进去之后
python源代码-简单手势识别.zip
python源代码-简单手势识别.zip
Python-用算法生成舞蹈动画
用算法生成舞蹈动画
Python库 | pycamera-0.3-py3-none-any.whl
python库,解压后可用。 资源全名:pycamera-0.3-py3-none-any.whl
Python_本地电影机构.zip
python
【人工智能开发环境】基于Anaconda的Python多环境管理:大模型技术项目中的包依赖隔离与Jupyter集成方案设计
内容概要:本文详细介绍了Anaconda这一面向数据科学与机器学习领域的综合性Python发行版,涵盖其核心功能、优势、安装配置流程及常用工具的使用方法。Anaconda集成了Python、Conda包与环境管理器、大量科学计算库(如NumPy、Pandas等)以及Jupyter Notebook和Spyder等开发工具,极大简化了开发环境的搭建过程。文章逐步讲解了Anaconda的下载、安装、环境变量配置、国内镜像源设置,并介绍了Conda的基本命令,包括环境创建、激活、软件包安装与管理等。此外,还演示了如何在命令行启动Jupyter、在PyCharm中集成Jupyter Notebook,以及常用快捷键的使用,帮助用户高效开展数据科学项目。; 适合人群:数据科学、机器学习初学者及希望快速搭建Python开发环境的科研人员与开发者;具备基础Python编程能力的学生或从业人员;需要管理多版本Python及依赖环境的技术人员。; 使用场景及目标:①快速部署数据科学开发环境,避免复杂的依赖配置;②利用Conda创建隔离的Python环境,解决项目间的版本冲突问题;③通过Jupyter进行交互式编程、数据探索与可视化展示;④在PyCharm等IDE中集成Jupyter,提升开发效率;⑤配置国内镜像源加速包下载,优化使用体验。; 阅读建议:建议读者按照文档步骤动手实践安装与配置过程,重点掌握Conda环境与包管理命令,并熟练运用Jupyter Notebook的常用操作与快捷键,以充分发挥Anaconda在实际项目中的效能。

改进差分进化算法及其求解柔性作业车间调度问题(Python代码实现)
内容概要:本文围绕改进差分进化算法及其在柔性作业车间调度问题中的应用展开,结合Python代码实现,系统阐述了算法的优化机制与求解流程。文章首先介绍差分进化算法的基本原理,进而针对柔性作业车间调度问题的复杂性,提出相应的改进策略,有效提升了算法在求解高维、多约束调度问题时的收敛速度与解的质量。通过仿真实验验证了改进算法在优化调度方案方面的有效性与鲁棒性,充分展示了其在智能制造与生产调度领域的实际应用价值。; 适合人群:具备一定编程基础,熟悉智能优化算法,从事生产调度、智能制造、工业工程等相关领域研究的研发人员与高校师生。; 使用场景及目标:①学习并掌握改进差分进化算法的设计思路、关键算子优化方法及其实现细节;②将其应用于柔性作业车间调度、多工序排产、生产计划优化等实际工程问题中,提升调度效率与资源利用率;③为相关科研课题提供算法模型支持与代码实现参考,推动智能优化技术的落地应用。; 阅读建议:建议读者结合文中提供的Python代码进行实践操作,逐步调试并理解算法每一步的实现逻辑,重点关注变异、交叉、选择等核心操作的改进策略,同时可尝试将其迁移至其他调度场景以加深理解与应用能力。
Tensorflow 2.1 报错整合
文章目录Tensorflow 2.1 报错整合RuntimeError: `loss` passed to Optimizer.compute_gradients should be a function when eager execution is enabled.RuntimeError: Attempting to capture an EagerTensor without building a function.RuntimeError: When eager execution is enabled, `var_list` must specify a list or dict
Data-Capture-OnlyMe
Data-Capture-OnlyMe
使用TensorFlow的自平衡机器人的手势控制-项目开发
使用TensorFlow Lite的深度学习对自平衡机器人进行手势控制。
解决TensorFlow模型恢复报错的问题
今天小编就为大家分享一篇解决TensorFlow模型恢复报错的问题,具有很好的参考价值,希望对大家有所帮助。一起跟随小编过来看看吧
Packt Building Machine Learning Projects with TensorFlow
TensorFlow 机器学习的教程,不可多得。 In recent years, machine learning has changed from a niche technology asset for scientific and theoretical experts to a ubiquitous theme in the day-to-day operations of the majority of the big players in the IT field. This phenomenon started with the explosion in the volume of available data: During the second half of the 2000s, the advent of many kinds of cheap data capture devices (cellphones with integrated GPS, multi-megapixel cameras, and gravity sensors), and the popularization of new high-dimensional data capture (3D LIDAR and optic systems, the explosion of IOT devices, etc), made it possible to have access to a volume of information never seen before. Additionally, in the hardware field, the almost visible limits of the Moore law, prompted the development of massive parallel devices, which multiplied the data to be used to train a determined models. Both advancements in hardware and data availability allowed researchers to apply themselves to revisit the works of pioneers on human vision-based neural network architectures (convolutional neural networks, among others), finding many new problems in which to apply them, thanks to the general availability of data and computation capabilities. To solve these new kinds of problems, a new interest in creating state-of-the-art machine learning packages was born, with players such as: Keras, Scikyt-learn, Theano, Caffe, and Torch, each one with a particular vision of the way machine learning models should be defined, trained, and executed. On 9 November 2015, Google entered into the public machine learning arena, deciding to open-source its own machine learning framework, TensorFlow, on which many internal projects were based. This first 0.5 release had a numbers of shortcomings in comparison with others, a number of which were addressed later, specially the possibility of running distributed models. So this little story brings us to this day, where TensorFlow is one of the main contenders for interested developers, as the number of projects using it as a base increases, improving its importance for the toolbox of any data science practitioner. In this book, we will implement a wide variety of models using the TensorFlow library, aiming at having a low barrier of entrance and providing a detailed approach to the problem solutions.
tensorflow 报错unitialized value的解决方法
今天小编就为大家分享一篇tensorflow 报错unitialized value的解决方法,具有很好的参考价值,希望对大家有所帮助。一起跟随小编过来看看吧
tensorflow2.1
该资源包括tensorflow2.1的各种语法,同时包含机器学习和深度学习各种实战例子,对于进一步学习深度学习有很大帮助。
Single-Image-SVBRDF-Capture-rendering-loss:具有渲染感知深度网络的单图像SVBRDF捕获
具有渲染感知深度网络的单图像SVBRDF捕获 该存储库包含我们的论文“具有渲染感知深度网络的单图像SVBRDF捕获,Valentin Deschaintre,Miika Aittala,Fredo Durand,George Drettakis,Adrien Bousseau。图形处理(Siggraph会议论文集),2018年8月”的代码。 该项目的网页可以在这里找到: : 预培训的数据可以在项目网页上找到。 论文摘要 纹理,高光和阴影是许多视觉提示中的一部分,可让人们感知单个图片中的素材外观。 然而,基于这样的线索从单个图像恢复空间变化的双向反射分布函数(SVBRDF)一直困扰着计算机图形学研究人员数十年。 我们通过训练深度神经网络来自动提取和理解这些视觉提示,从而解决了轻巧的外观捕获问题。 经过训练后,我们的网络能够从手持闪光灯照亮的平面图上恢复每个像素的法线,漫反射反照率,
Thought-Capture-Routing-v1.0-原创源码与文档.zip
原创本地工程工具合集,每个资源均包含独立源码、README、MIT License、原创与授权声明、3项自动化测试、可复现合成示例、离线 JSON、HTML、SVG 报告及 1080×720 真实运行截图。Node.js 18+ 可直接运行,适合开发者进行工程预检、数据校验和证据留档;不包含第三方项目源码、模型权重、官方素材或账号数据。
Building Machine Learning Projects with TensorFlow-Packt Publishing(2016).epub
In recent years, machine learning has changed from a niche technology asset for scientific and theoretical experts to a ubiquitous theme in the day-to-day operations of the majority of the big players in the IT field. This phenomenon started with the explosion in the volume of available data: During the second half of the 2000s, the advent of many kinds of cheap data capture devices (cellphones with integrated GPS, multi-megapixel cameras, and gravity sensors), and the popularization of new high-dimensional data capture (3D LIDAR and optic systems, the explosion of IOT devices, etc), made it possible to have access to a volume of information never seen before. Additionally, in the hardware field, the almost visible limits of the Moore law, prompted the development of massive parallel devices, which multiplied the data to be used to train a determined models. Both advancements in hardware and data availability allowed researchers to apply themselves to revisit the works of pioneers on human vision-based neural network architectures (convolutional neural networks, among others), finding many new problems in which to apply them, thanks to the general availability of data and computation capabilities. To solve these new kinds of problems, a new interest in creating state-of-the-art machine learning packages was born, with players such as: Keras, Scikyt-learn, Theano, Caffe, and Torch, each one with a particular vision of the way machine learning models should be defined, trained, and executed. On 9 November 2015, Google entered into the public machine learning arena, deciding to open-source its own machine learning framework, TensorFlow, on which many internal projects were based. This first 0.5 release had a numbers of shortcomings in comparison with others, a number of which were addressed later, specially the possibility of running distributed models. So this little story brings us to this day, where TensorFlow is one of the main contenders for interested developers, as the number of projects using it as a base increases, improving its importance for the toolbox of any data science practitioner. In this book, we will implement a wide variety of models using the TensorFlow library, aiming at having a low barrier of entrance and providing a detailed approach to the problem solutions.
 热门内容

 最新推荐

双闭环PWM整流器VOC控制 +SVPWM调制仿真(Simulink仿真实现)
仿真+课设Multisim直流可调稳压电源(0-15V)仿真设计基于LM317+LM337【仿真+课程报告】
阻尼器磁流变阻尼器MR Damper非线性(阻尼、滞回)特性研究(Matlab代码实现)
全桥LLC谐振(变频+移相混合控制)变换器闭环仿真模型(Simulink仿真实现)

全国各城市POI数据2012年-2023-最新整理zip
计算机组成原理全面解析PPT

Speaker Embedding工程黑盒全破译:x-vector_ECAPA-TDNN_OpenFace2在300ms内嵌入生成下的内存占用、鲁棒性、冷启动偏差三维度压测报告(含代码级调优参数)

GitHub推送后Jenkins流水线没反应,可能是哪些环节出了问题?
含风电系统的抽水蓄能容量优化与经济调度研究